本章,我们将实现 agent 的 MCP 协议。
Model Context Protocol(MCP)是 Anthropic 提出的开放协议,旨在标准化 AI 模型与外部工具/数据源的交互方式。它的核心设计理念是:模型不需要知道工具的实现细节,只需要知道工具的名字、描述和输入 Schema。
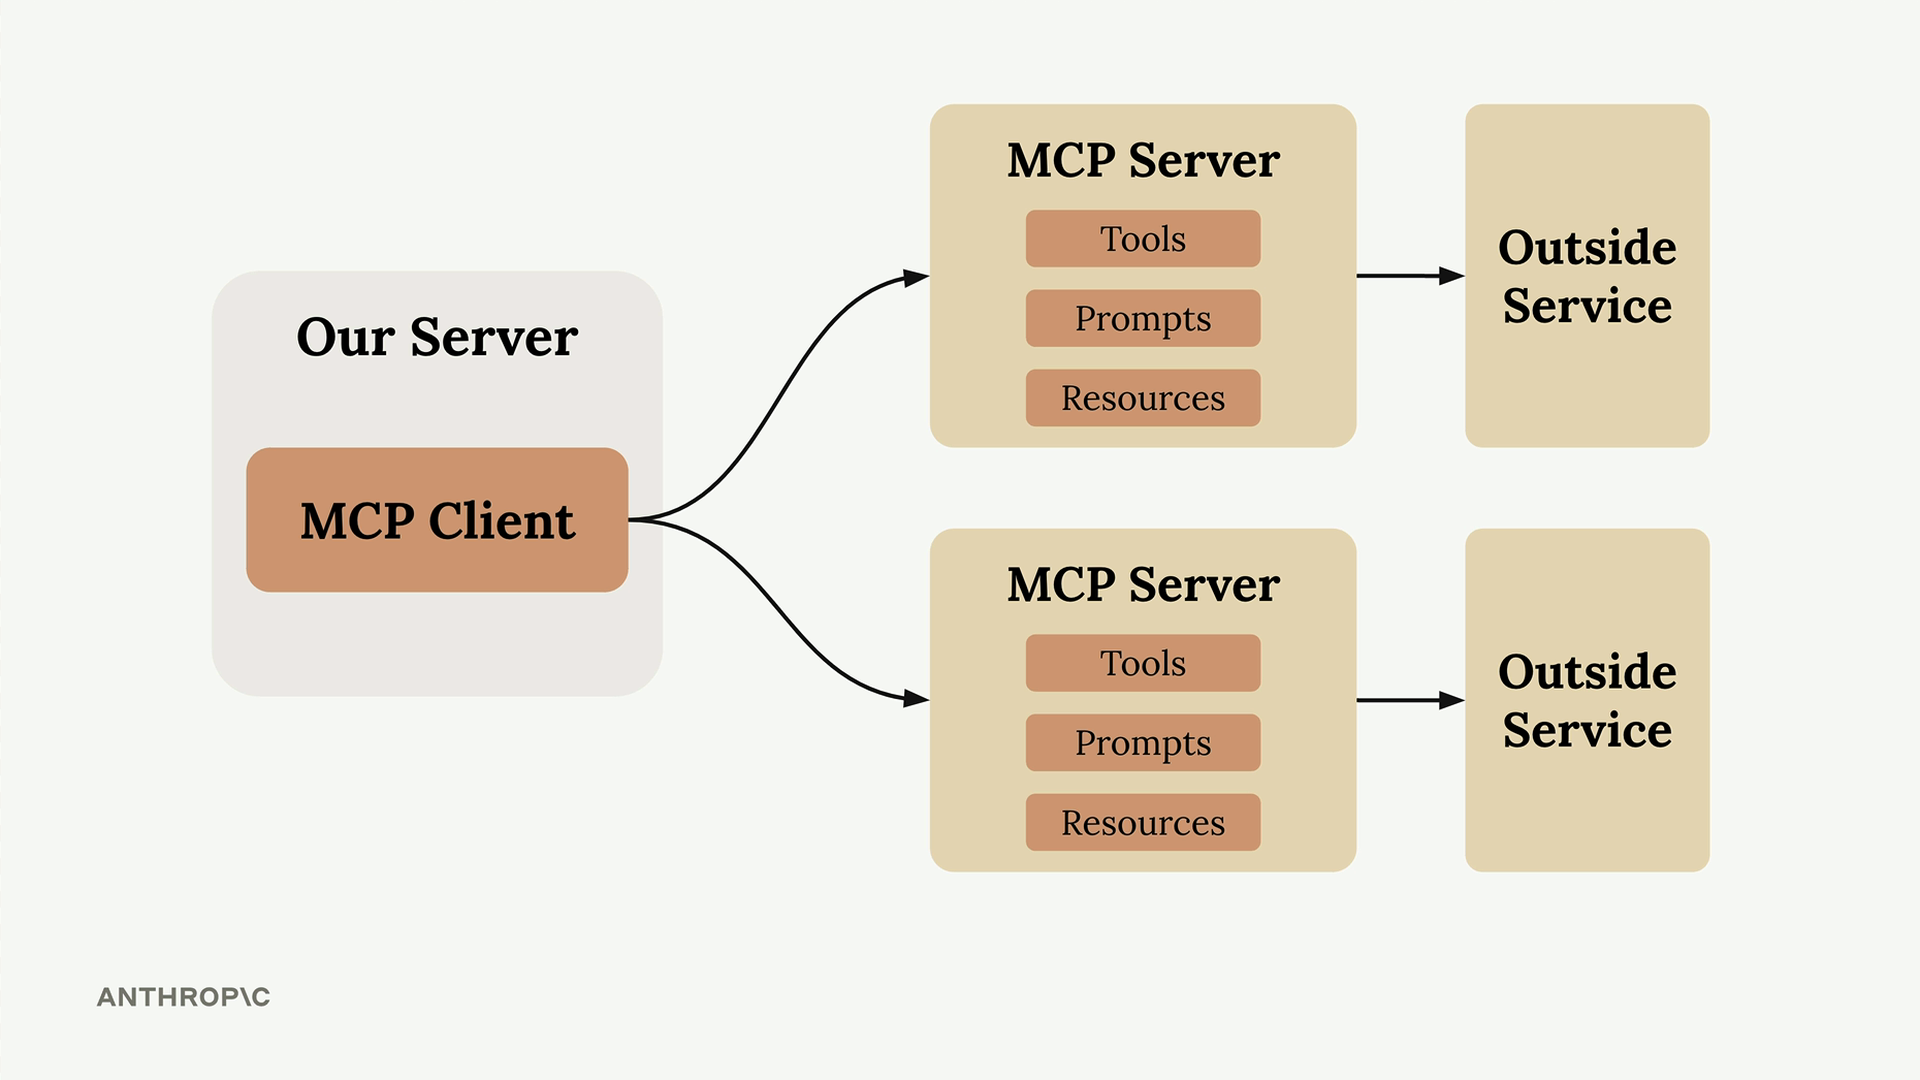
简单来说,MCP 把工具定义和执行从本地服务器转移到了专门的 MCP 服务器。如果没有 MCP,那么想要 agent 和一些外部网站交互时,就需要自己编写和测试所有的工具 schema 和函数;(他人编写好的)MCP 服务器直接接管了这些工作,它在内部封装了所需要的功能,并将其作为标准化的工具暴露在外。应用程序只需要连接到 MCP 服务器,不需要从头实现所有功能。
-> 任何人都可以创建 MCP 服务器,通常服务 provider 会自行开发官方的 MCP。
MCP 的基本架构包括 MCP client(在我们自己的服务器上)和 MCP server(包含了工具、prompt 和资源),后者充当和外部服务的接口。
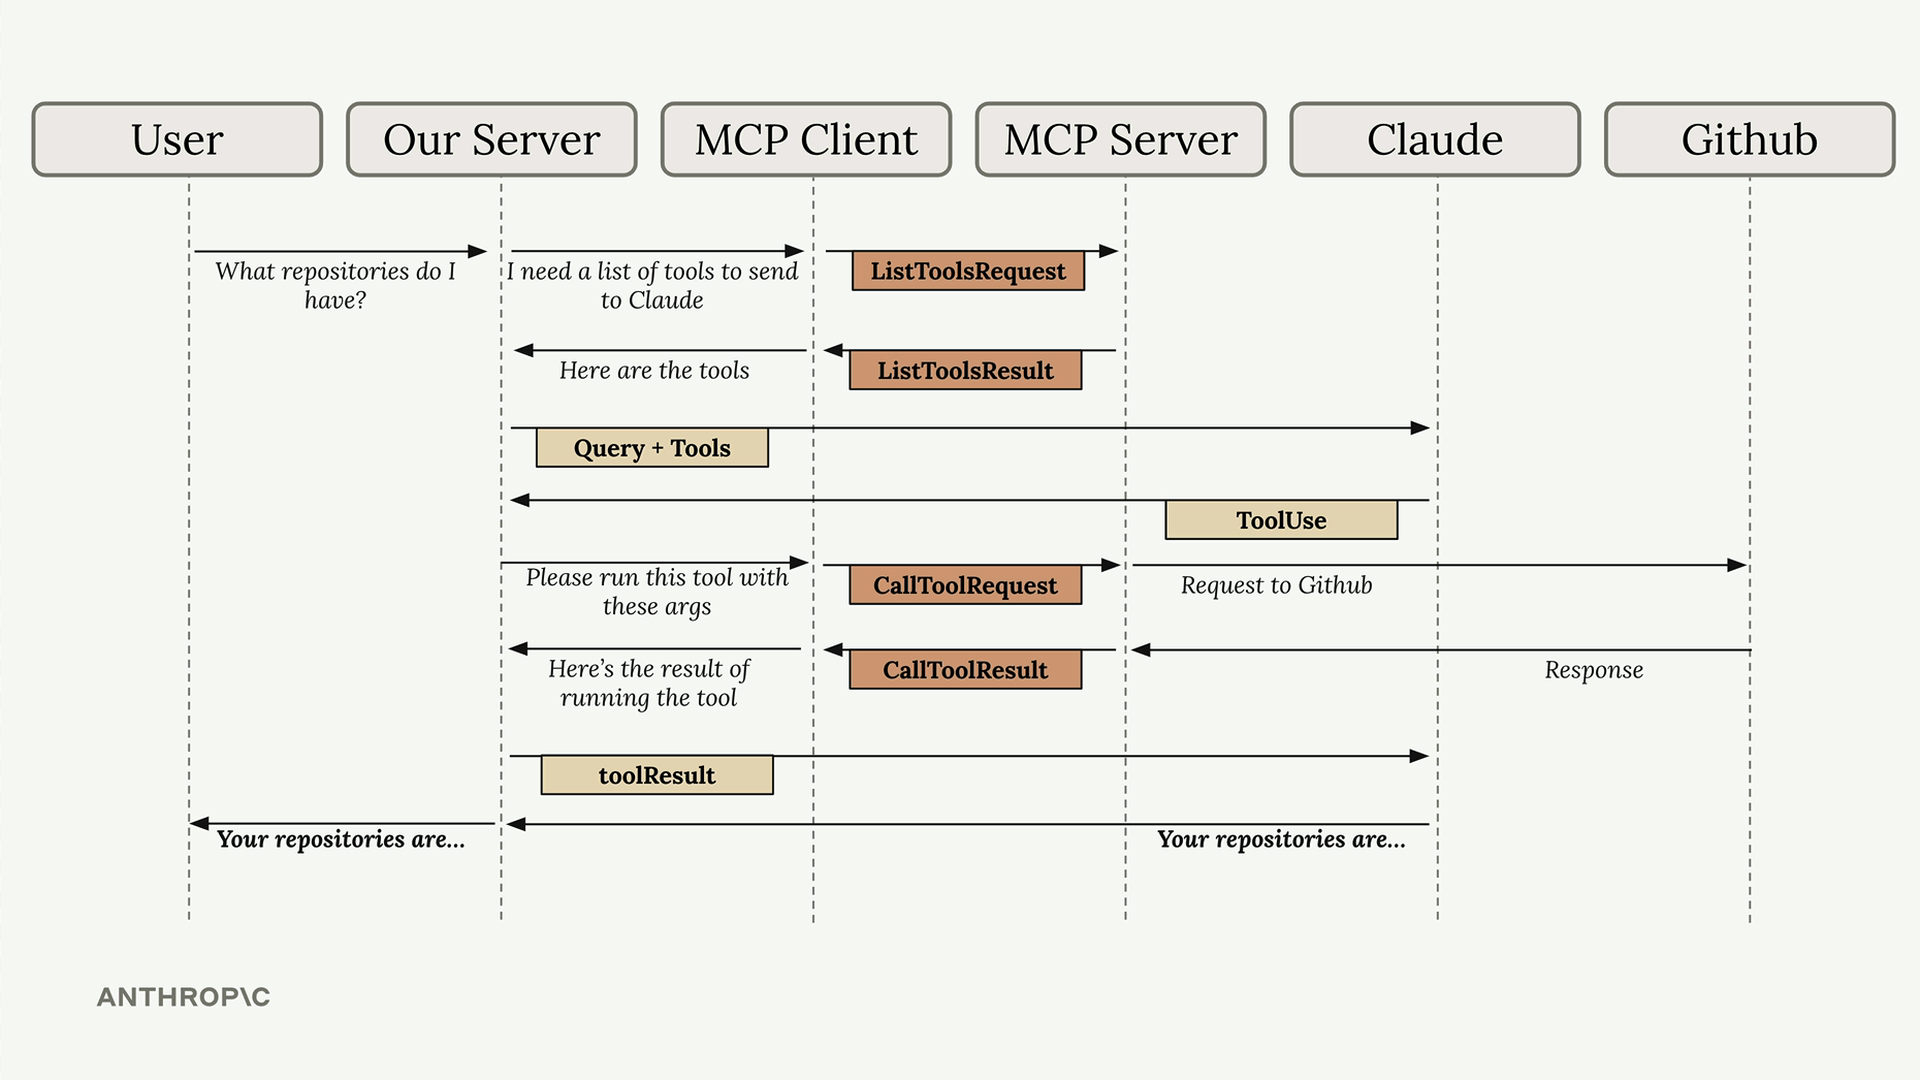
为了更直观地展示 MCP 的具体工作,这里转载一段 Anthropic 的说明:
以下是一个完整的示例,展示了用户查询如何流经整个系统——从服务器,通过 MCP 客户端,到 GitHub 等外部服务,再返回到 Claude。
假设用户询问“我有哪些代码库?”以下是详细步骤:
- User Query: 用户向服务器提交问题
- Tool Discovery: 服务器需要知道有哪些工具可以发送给 Claude
- List Tools Exchange: 服务器向 MCP 客户端请求可用工具
- MCP 通信: MCP 客户端向 MCP 服务器发送
ListToolsRequest请求,并接收ListToolsResult响应 - Claude 请求: 服务器将用户查询以及可用的工具发送给 Claude
- Tool Use 决策: Claude 决定需要调用一个工具来回答这个问题
- 工具执行请求: 服务器请求 MCP 客户端运行 Claude 指定的工具
- 外部 API 调用: MCP 客户端向 MCP 服务器发送
CallToolRequest请求,由 MCP 服务器发起实际的 GitHub API 调用 - 结果返回: GitHub 会返回代码库数据,这些数据会通过 MCP 服务器以
CallToolResult形式返回 - 工具结果发送给 Claude: 服务器将工具结果发送回 Claude
- 最终响应: Claude 使用代码库数据得出最终答案
- 用户收到答案: 服务器将 Claude 的回复返回给用户
传输抽象
MCP 规定的是消息格式和交互流程,并不限制消息一定通过哪一种网络协议传输。对 agent runtime 来说,最重要的是把传输层抽象成三个动作:
class Transport:
    def start(self) -> None: ...
    def request(self, method: str, params: dict | None = None) -> dict: ...
    def notify(self, method: str, params: dict | None = None) -> None: ...
    def stop(self) -> None: ...
request是请求-响应通信,消息包含唯一的id,发送方需要等待对应响应;notify是单向通知,没有id,也不期待响应;start/stop隐藏了子进程、HTTP client 和后台读取线程等传输细节。
上层的 MCPClient 只依赖这组接口,因此 handshake、工具发现和调用逻辑都不需要知道底层是 stdio 还是 HTTP。
MCP 的消息遵循 JSON-RPC 2.0。请求和通知的区别非常小:
def make_request(method: str, params: Optional[dict], req_id: int) -> dict:
    msg = {"jsonrpc": "2.0", "id": req_id, "method": method}
    if params is not None:
        msg["params"] = params
    return msg

def make_notification(method: str, params: Optional[dict] = None) -> dict:
    msg = {"jsonrpc": "2.0", "method": method}
    if params is not None:
        msg["params"] = params
    return msg
比如,列出工具是一个 request:
{"jsonrpc":"2.0","id":2,"method":"tools/list"}
而握手结束的通知没有 id:
{"jsonrpc":"2.0","method":"notifications/initialized"}
stdio
stdio 是本地 MCP server 最常见的传输方式。client 启动一个子进程,把 JSON-RPC 消息写入它的 stdin,再从 stdout 读取响应:
def start(self) -> None:
    env = {**os.environ, **(self._config.env or {})}
    cmd = [self._config.command] + list(self._config.args or [])
    self._process = subprocess.Popen(
        cmd,
        stdin=subprocess.PIPE,
        stdout=subprocess.PIPE,
        stderr=subprocess.PIPE,
        env=env,
    )
    self._running = True
    self._reader = threading.Thread(target=self._read_loop, daemon=True)
    self._reader.start()
    self._stderr_reader = threading.Thread(target=self._stderr_loop, daemon=True)
    self._stderr_reader.start()
本实现使用 newline-delimited JSON,即一行是一条完整消息。因为 client 可能同时发出多个请求,所以不能假设“下一条响应一定属于刚才的请求”,而要使用 JSON-RPC 的 id 做关联:
def request(self, method, params=None, timeout=None):
    with self._lock:
        req_id = self._next_id
        self._next_id += 1

    event = threading.Event()
    holder = {"event": event, "result": None}
    self._pending[req_id] = holder
    self._send_raw(make_request(method, params, req_id))

    event.wait(timeout=timeout or self._config.timeout)
    self._pending.pop(req_id, None)
    result = holder["result"]
    if result is None:
        raise TimeoutError(...)
    if "error" in result:
        raise RuntimeError(...)
    return result.get("result", {})
后台 reader 持续读取 stdout,从响应中取得 id,再唤醒等待该请求的线程:
def _read_loop(self):
    while self._running and self._process:
        raw = self._process.stdout.readline()
        if not raw:
            break
        msg = json.loads(raw.decode("utf-8"))
        msg_id = msg.get("id")
        if msg_id is not None and msg_id in self._pending:
            holder = self._pending[msg_id]
            holder["result"] = msg
            holder["event"].set()
这里有两个容易忽略的细节:
- stdin 写入需要加锁,否则多个线程写出的 JSON 可能交叉在一起;
- stderr 必须和 stdout 分开消费。stdout 是协议通道,不能混入日志;stderr 如果一直不读,又可能把操作系统 pipe 填满,最终让 server 卡住。
HTTP 和 SSE
远程 MCP server 不适合由 client 启动子进程,通常通过 HTTP 连接。本实现把 HTTP 和 SSE 放在同一个 HttpTransport 中:
- HTTP:将 JSON-RPC request POST 到 server URL,直接从 HTTP response 取得 JSON-RPC response;
- SSE:先 GET SSE endpoint,server 通过
endpoint事件返回本次 session 的 POST 地址;之后 request POST 到该地址,响应则通过持续打开的 SSE stream 以message事件异步返回。
def request(self, method, params=None, timeout=None):
    with self._lock:
        req_id = self._next_id
        self._next_id += 1
    msg = make_request(method, params, req_id)

    if self._config.transport == MCPTransport.SSE:
        event = threading.Event()
        holder = {"event": event, "result": None}
        self._sse_pending[req_id] = holder
        client.post(self._session_url, json=msg)
        event.wait(timeout=wait_secs)
        result = holder["result"]
    else:
        resp = client.post(self._config.url, json=msg, timeout=wait_secs)
        resp.raise_for_status()
        result = resp.json()
因此,两种 transport 虽然收发方式不同,但最终都实现了相同的 request/notify 语义。
Server 配置
我们使用和 Claude Code 类似的 .mcp.json 格式。一个配置文件可以声明多个 server:
{
  "mcpServers": {
    "git": {
      "type": "stdio",
      "command": "uvx",
      "args": ["mcp-server-git"],
      "env": {"LOG_LEVEL": "warning"},
      "timeout": 30
    },
    "remote": {
      "type": "sse",
      "url": "http://localhost:8080/sse",
      "headers": {"Authorization": "Bearer token"}
    }
  }
}
配置进入 runtime 后会被解析为一个统一的数据结构:
@dataclass
class MCPServerConfig:
    name: str
    transport: MCPTransport = MCPTransport.STDIO
    # stdio
    command: str = ""
    args: List[str] = field(default_factory=list)
    env: Dict[str, str] = field(default_factory=dict)
    # SSE / HTTP
    url: str = ""
    headers: Dict[str, str] = field(default_factory=dict)
    # common
    timeout: int = 30
    disabled: bool = False
这个数据结构的作用,是让后面的连接逻辑不再反复处理松散的 JSON 字段。同时,server 的名字不是 server 自己返回的名字,而是配置字典里的 key,例如上面的 git;它也是工具命名空间的一部分,所以应该稳定且唯一。当前实现最好只使用字母、数字和下划线作为 server name:注册时会清洗 qualified name,而 Manager 查找连接时仍使用原始配置名,带 - 等字符的名字可能无法正确反查。
配置有两个 scope:
~/.nano_claude/mcp.json    # user scope,对所有项目生效
<project>/.mcp.json        # project scope,只对当前项目生效
加载时先读 user 配置,再从当前工作目录向上查找最近的 .mcp.json,最后按 server name 合并,project 配置覆盖同名的 user 配置:
def load_mcp_configs() -> Dict[str, MCPServerConfig]:
    servers = _load_file(USER_MCP_CONFIG)

    p = Path.cwd()
    for _ in range(10):
        candidate = p / ".mcp.json"
        if candidate.exists():
            servers.update(_load_file(candidate))  # project wins
            break
        if p.parent == p:
            break
        p = p.parent

    return {
        name: MCPServerConfig.from_dict(name, raw)
        for name, raw in servers.items()
    }
这和前面 Skills、Memory 中的 scope 设计一致:全局配置提供默认能力,项目配置提供更具体的能力并拥有更高优先级。
MCP 配置是一个信任边界,而不只是普通偏好设置。
command可以启动本地进程,env、headers可能包含凭据,远程 server 返回的工具描述和结果也都是外部输入。因此 project 中的.mcp.json不应该在未审查时自动信任,密钥也不适合直接提交到仓库。本实现为了突出主流程,尚未实现配置授权、环境变量展开、OAuth 和 secret storage。
Server 生命周期管理
一个 MCP server 从“配置存在”到“可以调用工具”,需要经过一套固定的初始化协议:
DISCONNECTED
    │ connect()
    ▼
CONNECTING
    │ start transport
    │ initialize request
    │ notifications/initialized
    ▼
CONNECTED
    │ tools/list
    │ tools/call ...
    │ disconnect() / error
    ▼
DISCONNECTED / ERROR
初始化握手
client 首先发送 initialize,声明自己的协议版本、client 信息和 capabilities:
INIT_PARAMS = {
    "protocolVersion": "2024-11-05",
    "capabilities": {
        "tools": {},
        "roots": {"listChanged": False},
    },
    "clientInfo": {
        "name": "nano-claude-code",
        "version": "1.0.0",
    },
}
server 的响应中会包含它选择的协议版本、身份信息和 capabilities。client 缓存这些字段,然后发送 notifications/initialized,表示握手完成:
def _handshake(self) -> None:
    result = self._transport.request("initialize", INIT_PARAMS, timeout=15)
    self._server_info = result.get("serverInfo", {})
    self._capabilities = result.get("capabilities", {})
    self._transport.notify("notifications/initialized")
这里的 capabilities negotiation 很重要:MCP server 不一定提供工具,也可能只提供 resources 或 prompts。只有 server 声明了 tools capability,我们才应该请求 tools/list:
def list_tools(self) -> List[MCPTool]:
    if self.state != MCPServerState.CONNECTED:
        raise RuntimeError("server is not connected")

    if "tools" not in self._capabilities:
        self._tools = []
        return self._tools

    result = self._transport.request("tools/list", timeout=15)
    self._tools = [self._parse_tool(t) for t in result.get("tools", [])]
    return self._tools
当前简单实现只消费 tools capability;MCP 的 resources、prompts、sampling 等能力没有接入 agent loop。
2026.07:MCP 已经取消这套握手流程,每个请求自己携带 protocol version、client info 和 capabilities;如果 Client 想预先知道 Server 有什么能力,可以调用新的
server/discover,但不是必须,这样一来更容易横向扩容。
Client 和 Manager
MCPClient 管理一个 server 的 transport、状态、能力和工具缓存;MCPManager 则管理所有 client:
class MCPManager:
    def __init__(self):
        self._clients: Dict[str, MCPClient] = {}

    def add_server(self, config): ...
    def connect_all(self): ...
    def connect_server(self, name): ...
    def all_tools(self): ...
    def call_tool(self, qualified_name, arguments): ...
    def disconnect_all(self): ...
Manager 被做成 module-level singleton,原因是 tool registry 中的 wrapper 和 REPL 的 /mcp 命令必须访问同一批连接及其状态:
_manager: Optional[MCPManager] = None

def get_mcp_manager() -> MCPManager:
    global _manager
    if _manager is None:
        _manager = MCPManager()
    return _manager
连接失败不能拖垮整个 agent。connect_all() 会逐个连接 server,将每个结果记录为 {server_name: error_or_none};某个 server 出错时,其他 server 仍可正常注册工具。工具实际调用时,如果发现连接已经断开,Manager 会先自动 reconnect、重新获取工具列表,然后重试调用:
if not client.alive:
    client.reconnect()
    client.list_tools()
return client.call_tool(original_name, arguments)
为了不让本地 MCP server 的启动时间阻塞 CLI,mcp/tools.py 在 import 时用 daemon thread 做初始化:
def _background_init():
    try:
        initialize_mcp()
    except Exception:
        pass

_bg_thread = threading.Thread(target=_background_init, daemon=True)
_bg_thread.start()
这是一种启动速度与能力立即可用之间的 tradeoff:CLI 可以马上显示,但用户的第一条消息如果来得非常快,MCP 工具可能尚未注册。成熟实现通常需要显式的 ready 状态、连接进度事件,或者在第一次构造 tool list 时等待初始化完成。
工具注册
server 返回的 MCP tool 大致长这样:
{
  "name": "git_status",
  "description": "Show git working tree status",
  "inputSchema": {
    "type": "object",
    "properties": {
      "repository": {"type": "string"}
    },
    "required": ["repository"]
  },
  "annotations": {
    "readOnlyHint": true
  }
}
它和 内置工具的 schema 已经非常接近了。适配层只需要做三件事:建立全局唯一的名字、把 schema 转换成 provider 所需格式、生成一个把调用转发回 MCP server 的函数。
工具命名空间
不同 server 完全可能暴露同名工具,例如 read_file。因此 MCP 工具不能直接用 server 返回的原名注册,而要加上命名空间:
mcp__<server_name>__<tool_name>

mcp__git__git_status
mcp__filesystem__read_file
解析工具时,还会把字母、数字和下划线以外的字符替换成 _,避免违反模型 API 对 tool name 的限制:
qualified = f"mcp__{self.config.name}__{tool_name}"
qualified = "".join(
    c if c.isalnum() or c == "_" else "_"
    for c in qualified
)
调用时不能直接把清洗后的后缀发给 server,因为 server 只认识原始名字。Manager 会用 qualified_name 在缓存的 MCPTool 中反查 tool_name,再发出 tools/call。
统一 Tool Registry
MCPTool.to_tool_schema() 将远程定义转换成 agent 已有的 schema:
def to_tool_schema(self) -> dict:
    return {
        "name": self.qualified_name,
        "description": f"[MCP:{self.server_name}] {self.description}",
        "input_schema": self.input_schema or {
            "type": "object",
            "properties": {},
        },
    }
然后为每项工具生成一个 closure,捕获 qualified name,并注册成普通的 ToolDef:
def _make_mcp_func(qualified_name: str):
    def _mcp_tool(params: dict, config: dict) -> str:
        mgr = get_mcp_manager()
        try:
            return mgr.call_tool(qualified_name, params)
        except Exception as e:
            return f"Error calling MCP tool '{qualified_name}': {e}"
    return _mcp_tool

def _register_tool(tool: MCPTool) -> None:
    register_tool(ToolDef(
        name=tool.qualified_name,
        schema=tool.to_tool_schema(),
        func=_make_mcp_func(tool.qualified_name),
        read_only=tool.read_only,
        concurrent_safe=False,
    ))
这一步体现了 Tool Registry 的价值:注册结束以后,agent loop 不再区分内置工具和 MCP 工具。get_tool_schemas() 会把两者一起发给模型,execute_tool() 也通过同一个 registry 分发调用。新增一个 MCP server 不需要修改 agent loop。
整个启动注册链路如下:
import tools
  └─ import mcp.tools
       └─ background initialize_mcp()
            ├─ load_mcp_configs()
            ├─ manager.add_server(config)
            ├─ manager.connect_all()
            │    ├─ initialize
            │    ├─ notifications/initialized
            │    └─ tools/list
            └─ register_tool(ToolDef(...))
                         │
                         ▼
              get_tool_schemas()
                         │
                         ▼
                   model API
工具调用
当模型选择 mcp__git__git_status 时,后半段调用链是:
LLM tool call
  → agent loop permission gate
  → tool_registry.execute_tool(...)
  → generated MCP wrapper
  → MCPManager.call_tool(...)
  → MCPClient.call_tool(original_name, arguments)
  → transport.request("tools/call", params)
  → MCP server
  → external service
发给 MCP server 的参数遵循固定格式:
params = {
    "name": tool_name,
    "arguments": arguments,
}
result = self._transport.request(
    "tools/call",
    params,
    timeout=self.config.timeout,
)
返回值不是一个简单字符串,而是一组 content blocks,可能包含 text、image 或 embedded resource。本实现最终要把结果写回纯文本形式的 agent message,所以做了一个有损的归一化:
parts = []
for block in result.get("content", []):
    if block.get("type") == "text":
        parts.append(block.get("text", ""))
    elif block.get("type") == "image":
        parts.append(f"[image: {block.get('mimeType', 'unknown')}]")
    elif block.get("type") == "resource":
        parts.append(f"[resource: {block.get('resource', {}).get('uri', '')}]")

text = "\n".join(parts) if parts else str(result)
if result.get("isError", False):
    return f"[MCP tool error]\n{text}"
return text
这里要区分两层 error:
- JSON-RPC error:协议或请求失败,response 顶层包含
error,transport 抛出异常; - tool execution error:JSON-RPC 调用本身成功,但工具执行失败,result 中的
isError为 true,它仍然是一个合法的 tool result,应该反馈给模型,让模型决定下一步怎么做。
和普通工具一样,MCP 结果最后会经过 registry 的统一截断逻辑,再作为 role: "tool" 消息加入 history,进入下一轮 Agent Loop。
权限和信任边界
MCP 解决的是互操作问题,不会自动解决权限问题。server 的 annotations.readOnlyHint 只是提示(hint),不是安全保证;第三方 server 完全可能标错,或者工具在看似只读的调用中产生副作用。
本实现虽然把 readOnlyHint 保存为 ToolDef.read_only,但当前 agent loop 的权限判断仍然只显式放行几个内置只读工具:
if name in ("Read", "Glob", "Grep", "WebFetch", "WebSearch"):
    return True
...
return False
因此 MCP 工具默认会请求用户确认。这种默认拒绝更安全,不过还没有完整利用 tool annotation。更成熟的 permission pipeline 至少需要同时考虑:
- server 本身是否已被用户信任;
- tool annotation 和本地 policy;
- 参数级规则,例如允许读取某个目录但不允许写入;
- 本地 stdio 进程的 command、env 和文件系统权限;
- 远程 server 的 URL、认证信息、TLS 和数据出境风险;
- 返回内容中的 prompt injection,以及过大的结果对 context 的污染。
换言之,MCP server 应被视为一个外部执行主体,而不是普通依赖库。
REPL 管理
为了观察和管理连接,REPL 增加了几条 /mcp 命令:
/mcp                         查看 server 状态及已发现的工具
/mcp reload                  重连所有 server,并刷新工具列表
/mcp reload <name>           重连单个 server
/mcp add <name> <cmd> [...]  将 stdio server 写入 user 配置
/mcp remove <name>           从 user 配置删除 server
/mcp 展示的是 Manager 中的 runtime 状态,包括 connected / connecting / disconnected / error、server 版本、工具数量和连接错误。这一点很重要:配置文件只说明“用户希望连接什么”,状态命令说明“现在实际上连上了什么”。
MCP 的边界与设计原则
回到这一系列的整体架构,MCP 并没有创造一种新的 Agent Loop,它只是在 Tool System 外面增加了一层标准化的远程适配:
Skill                 MCP
  │ 注入做事方法         │ 暴露可调用能力
  ▼                     ▼
conversation        Tool Registry
context                 │
                        ▼
                    Agent Loop
MCP 和 Skills 很容易混淆,但两者解决的问题不同:Skills 主要封装“应该如何完成任务”的知识、流程和执行上下文;MCP 主要封装“有哪些外部能力可以调用”以及如何调用。一个数据库 MCP server 可以提供 query 工具,而一个数据分析 Skill 可以告诉 agent 应该按什么顺序检查 schema、写查询、验证结果;二者可以组合,而不是相互替代。
这个简单实现展示了 MCP 接入 Agent 最核心的四层:
- 用统一 transport 隐藏 stdio、SSE、HTTP 的差异;
- 用 JSON-RPC 和初始化握手建立标准化 session;
- 用
tools/list动态发现能力,并适配到本地 Tool Registry; - 用
tools/call把 agent 的结构化调用转发到外部 server,再把结果送回原来的 Agent Loop。
它也将一些 production 问题留白,没有实现:协议版本协商与兼容、分页后的 tools/list、tools/list_changed 通知、resources/prompts、OAuth、连接健康检查、指数退避、严格 schema 校验、结构化多模态结果、动态注销旧工具,以及更细粒度的权限策略。
最重要的设计原则仍然和 Tool System 一章相同:外部工具最终要被归一化为内部统一接口。Agent Loop 不应该了解每一种 server 和 transport;它只需要看到名字、描述、输入 schema 和一个可调用函数。扩展性来自边界的稳定,而不是在主循环中不断加入特例。